

AI模擬教學支援準教師備課 91名師範生的前後評估
研究以91名小學教育師範生進行準實驗,44人使用聊天機械人練習備課、模擬教學並接收AI回饋,47人為未接受介入的對照組。八次模擬前後評估顯示,介入組整體備課能力改善,尤其在設計例題及提出深入問題方面,教學知識與教學自我效能亦有提升。研究採非隨機分組,結果反映這項師訓安排的表現,仍須配合真實課堂經驗檢視。
Zhetysu University、Central Asian Innovation University
研究以91名小學教育師範生進行準實驗,44人使用聊天機械人練習備課、模擬教學並接收AI回饋,47人為未接受介入的對照組。八次模擬前後評估顯示,介入組整體備課能力改善,尤其在設計例題及提出深入問題方面,教學知識與教學自我效能亦有提升。研究採非隨機分組,結果反映這項師訓安排的表現,仍須配合真實課堂經驗檢視。
鄧飛主張按年齡及教學目的設計AI使用,低年級維持受控使用,高年級逐步增加人機協作。他建議讓學生查證、比較及批判AI答案,評估加入口頭答辯、使用紀錄與反思,並以持續研究追蹤學習及公平影響,讓學生在教師引導下保留獨立思考。
研究標題是入口。讀懂比較對象、成效指標及適用範圍,才能形成自己的判斷。
研究運用逾109萬名學生的考試資料,結合31項學業、教學及社會經濟因素,比較不同成績預測模型。分區訓練只交換模型更新,各區保留原始資料;個人化模型的整體預測表現略高於兩個集中訓練模型。過往成績的預測力最強,環境因素的影響則因地區而異。研究使用模擬分區資料,著重預測準確程度,未測試模型能否改善學生學習。
研究將1,053名一年級經濟、管理及金融本科生分配至因果推理訓練、ChatGPT、兩者兼有或對照條件,要求他們處理真實商品營銷問題。AI提高作業評分、文字連貫性及構思數量;推理訓練未顯著提高評分,卻增加機制分析及構思多樣性,兩者並用保留了相關作用。研究集中一次作業及特定評準,沒有測量移除工具後的知識保留或長期能力。
研究分析美國50所獲評為最具創新性大學的官方網站,以文件分析及主題分析整理生成式人工智能政策。共同做法包括由教師訂定課程規則、要求申報使用情況、保障資料私隱、審慎採用人工智能偵測,以及提供素養培訓。各校在使用許可、工具選擇及管理成熟程度上仍有差異,支援則分布於教學中心、圖書館、資訊科技部門和學術誠信辦公室。
研究以297份設計學生資料,分析AI助手的技術品質、擬人化、信任及愉悅感,與學生感受到的學習支援之間的關係。信任和愉悅感與自評支援呈正向關聯,技術品質主要透過兩者間接連繫;擬人化雖與較高信任及愉悅感相關,對支援感亦有輕微負向直接關聯。研究量度主觀感受,不能把模型中的關係當作因果,或換算成學習成績的進步。
研究重分析218名大學生使用自適應系統學習認知心理學詞彙的紀錄,共25,843組學習序列,間隔由數秒至數星期不等。固定參數的遺忘模型難以同時描述短期和長期表現,按時間間隔調整參數後,對保留資料的預測較佳。這是既有行為資料的模型比較,沒有把學生隨機分配到不同複習系統,亦未證明採用新模型便能提高學習成績。
研究在美國六千多名初中生的數學練習中,隨機比較AI與一般電腦支援,以及不同掌握學習規則,一周後再評估。AI組進度較慢、題量較少,但在已作答的題目中準確度較高,錯題後下一次答對的比例亦增加。延後測驗較正面的結果集中在AI配合掌握學習流程及部分已練習內容,且部分差異只達邊緣顯著,未足以確認廣泛的數學遷移效果。
研究調查342名中國大學生,分析AI查資料、生成內容及修訂文字,與自評批判思考的關係。查資料呈正相關,生成內容呈負相關,修訂文字則未見顯著關聯。內在動機加強查資料的正向關聯,亦加強生成內容的負向關聯;外在動機則減弱後者。研究採用一次自陳問卷,沒有客觀思考測驗,認知負荷亦未直接量度,不能據此確定AI造成能力改變。
研究以隨機實驗比較大學生在有或沒有生成式AI協助下,閱讀陌生議題及撰寫分析文章的表現,並安排即時和一周後的獨立測驗。AI組的即時知識測驗高出0.27個標準差,優勢維持至一周後;當下文章質素變化不大,延後寫作的風格和切題程度則有所改善。以AI解釋概念者的延後進步較大,但使用方式由學生自行選擇,不能據此確定不同用法的因果效果。
研究將74名四年級醫學生隨機分成兩組,在同一教師教授的青光眼課程中,比較DeepSeek輔助問題導向學習與傳統教學。AI結合問題導向學習組的理論測驗、問診、診斷推理及整體臨床表現較佳,學生同時擔心AI醫療建議不準確。由於工具和教學方式一併改變,結果不能單獨歸因於AI;研究規模及追蹤時間亦有限。
研究分析德國三所中學98名九年級學生,在數學課使用AI導師的1,616個對話回合,並收集前後測、學習需要及認知負荷資料。學生事前多希望得到概念解釋和逐步支援,實際對話卻少有明確檢查或評估自己的理解。後測表現低於前測,額外認知負荷亦與較低分數相關。對話分類仍屬AI初步編碼,研究沒有無AI對照組,不能斷定工具導致退步。
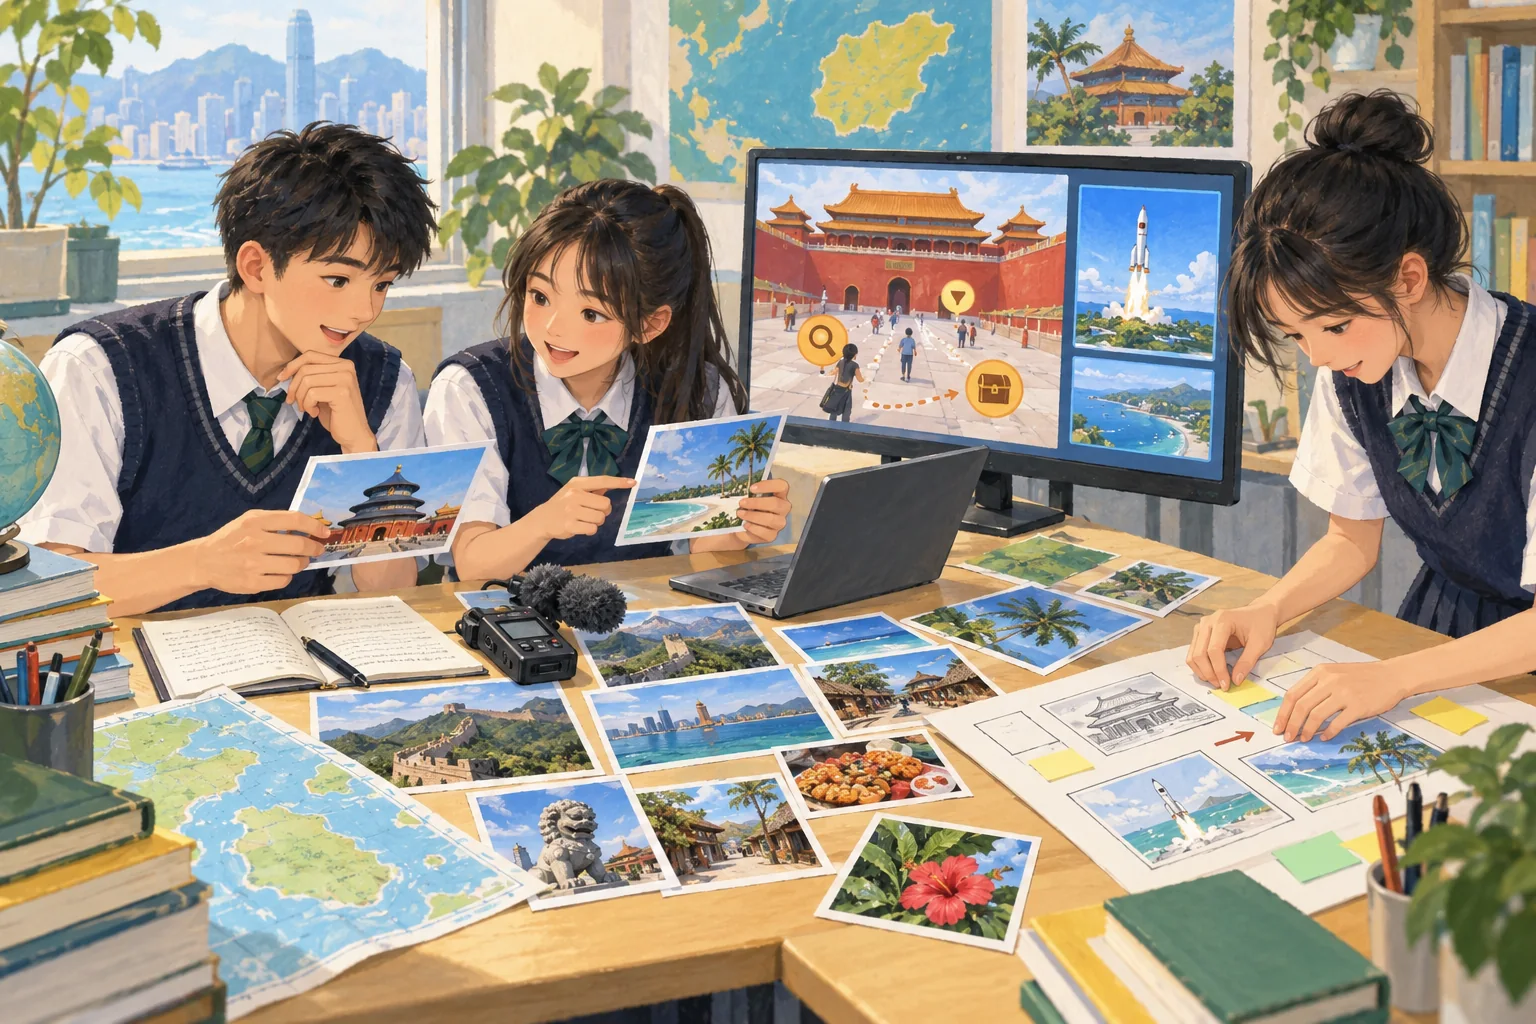
香港管理專業協會羅桂祥中學把北京、海南研學素材帶回課堂。六名學生以全景照片、影像及訪問記錄文化與科技見聞,再運用AI、Genially及Unity,製作故宮尋寶、火箭發射等互動作品。公開課讓未參與考察的同學透過任務接觸相關內容,公民科及公經社科亦安排遊戲設計與同儕回饋。
研究以60名小四學生進行六周詩歌寫作活動,實驗組接受ChatGPT形成性回饋並修訂作品,對照組沒有AI支援。控制前測後,實驗組的詩歌寫作評分及對詩歌的態度均較佳。活動由教師引導處理回饋,並非讓學生自行使用聊天工具。研究只涉及一校兩班,沒有長期追蹤,亦未能分離額外回饋、修訂練習與AI本身各自的作用。
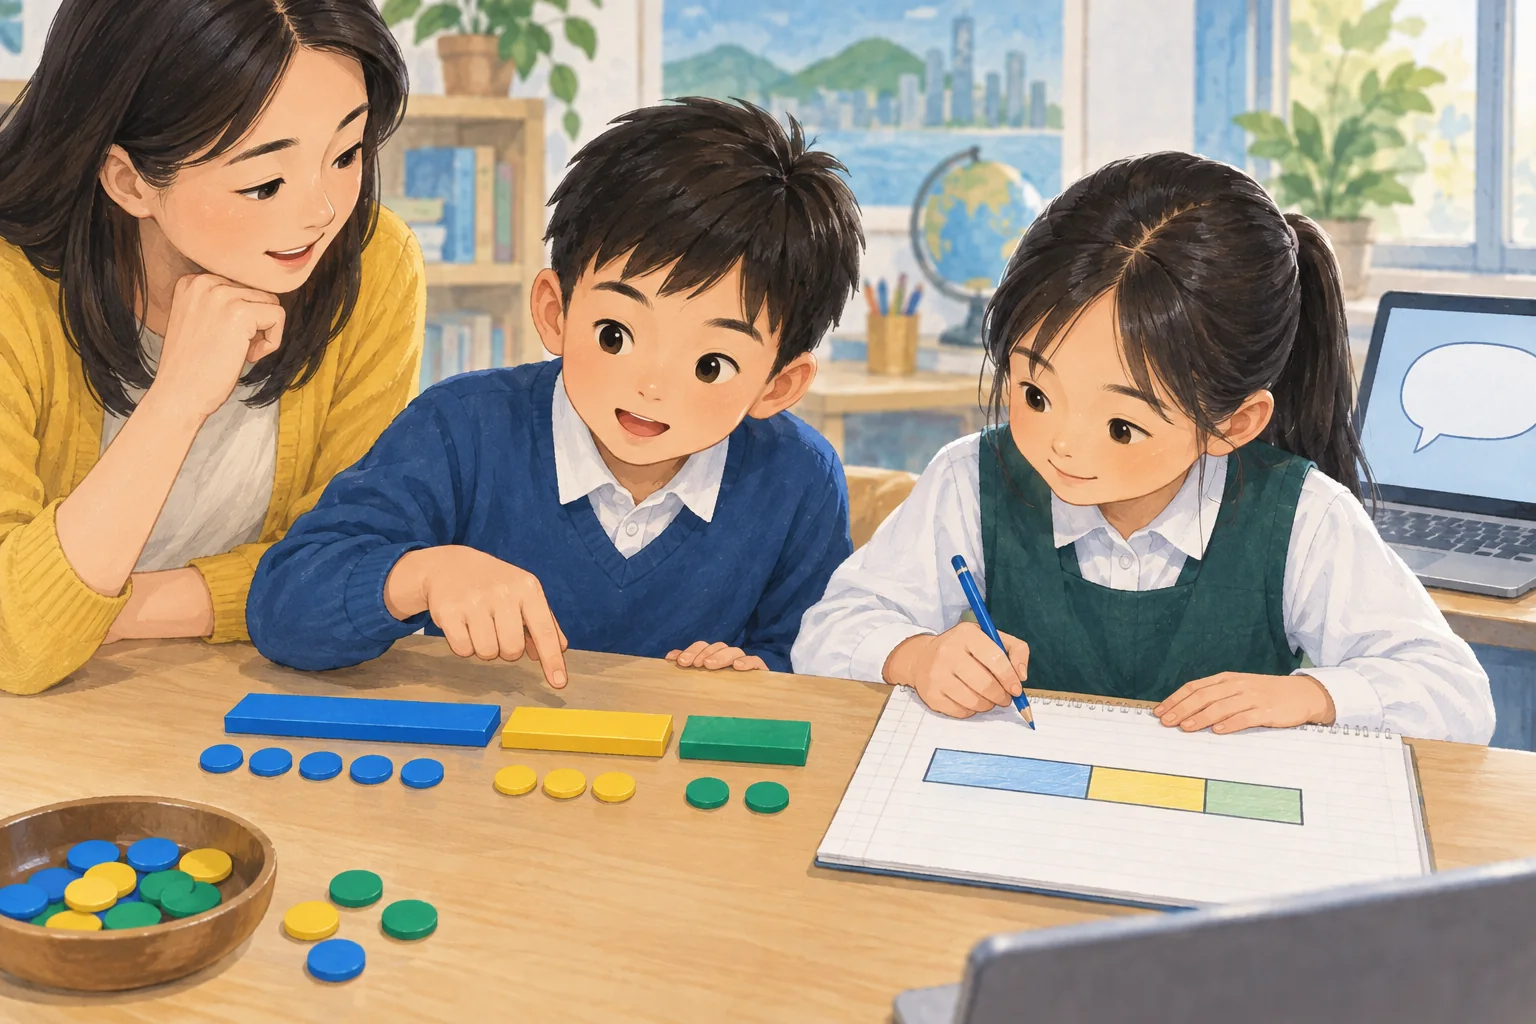
中華基督教會基法小學以Microsoft Copilot輔助五年級方程文字題教學,處理學生理解題意和數量關係時的困難。課程從元素、關係、表徵及系統四個層面組織提問,引導學生先辨識題目中的各個量,再理清它們的關係,逐步建立列式所需的思路。AI的用途集中在提問與理解過程,配合學生開始學習方程的需要。
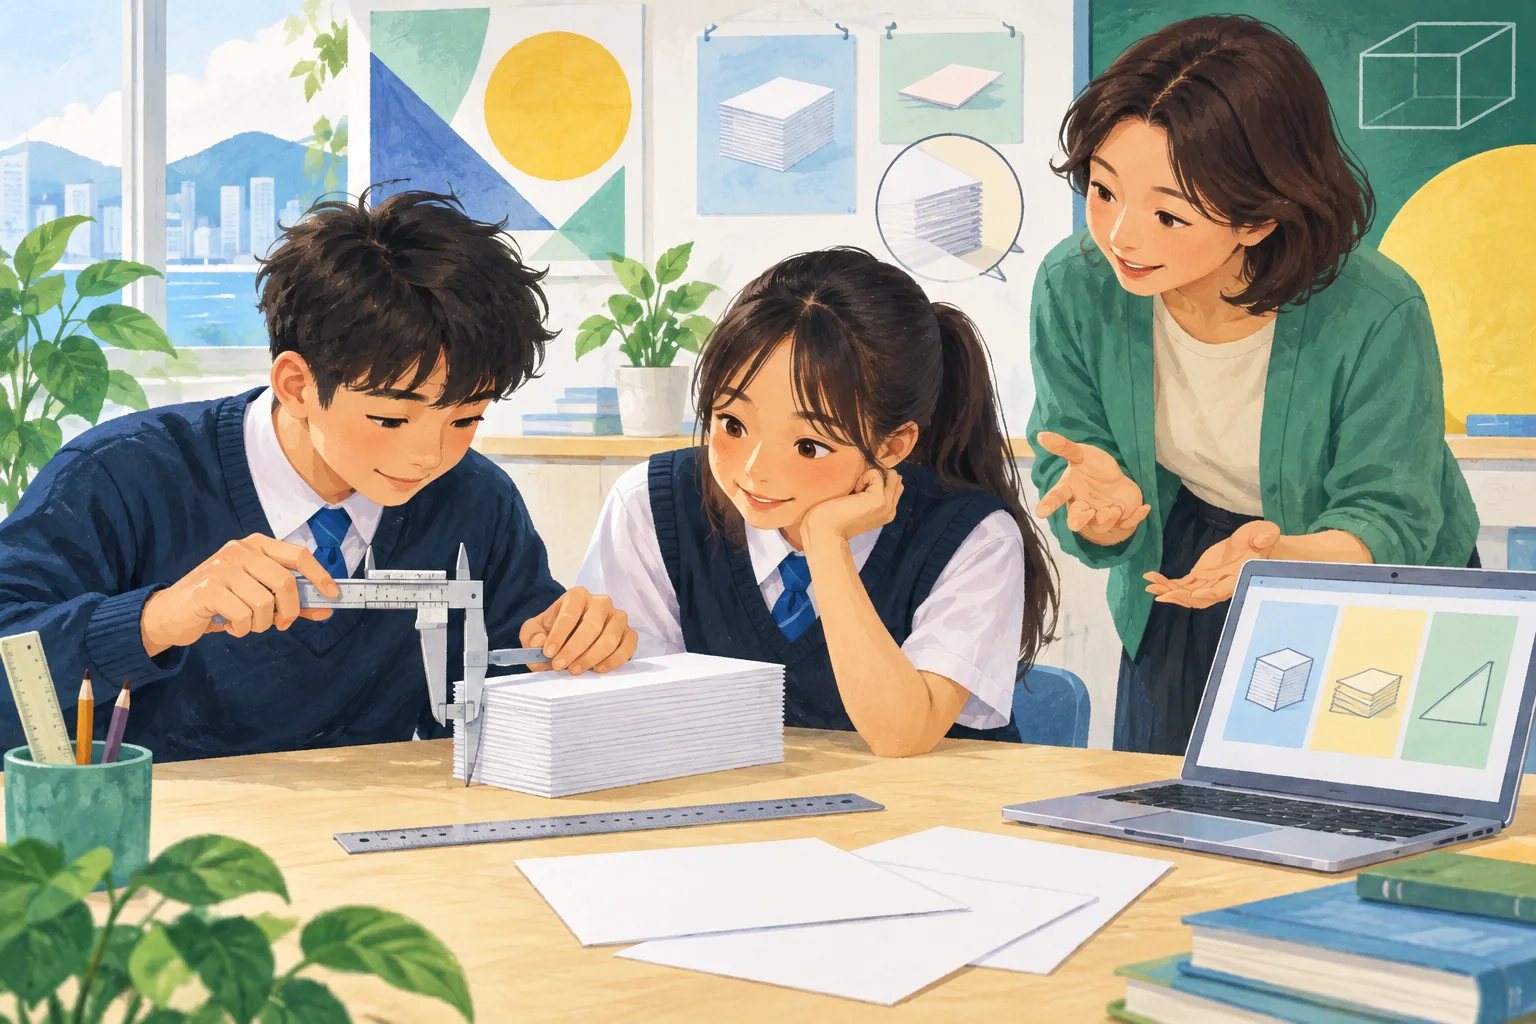
路德會呂祥光中學數學科把AI回饋加入解題與量度探究。學生先自行計算代數分式,再查看Photomath的步驟,比較自己的計算與AI答案,並追問因式分解的方法。另一項任務要求學生向AI索取量度紙張厚度的方案,再判斷工具是否合用,透過實際量度改進做法,列出儀器及操作可能造成的誤差。
研究以六道電場及高斯定律選擇題,分別用英語及土耳其語提問ChatGPT-4o,再由三名物理教育學者及一名評估學者分析回覆。評閱涵蓋理解、應用、分析和計算,除了答案正確性,亦檢視概念連繫及推理一致性。英語回覆在各層面較佳;土耳其語題涉及多步推理或情境解讀時,表現下降較明顯。研究限於六題,未直接量度學生學習成效。
研究調查香港中文大學107名社會科學本科生,按認知要求區分AI用途,並以迴歸分析檢視使用頻率與累積平均積點的關係。控制部分人口、態度及家庭因素後,用AI校對、摘要及整理資料等較低階任務與成績呈正相關,中階及高階任務則未見顯著關聯。研究採用單校橫斷問卷,不能確定因果,也沒有直接量度學生的分析能力或概念理解。
文章結合概念分析及近期研究,探討教師、學生與人工智能如何在回饋過程中合作,重點比較回饋的及時性、準確程度、細節、可理解程度及語氣。分析亦把師生關係和學生參與判斷、回應及修改的過程納入考慮,涉及內地師生資料。文章屬研究綜合,著重釐清不同回饋來源的特點與合作方式,沒有以實驗比較人與人工智能回饋對成績的個別效果。
公民科教師可先用AI整理時事及政策背景,再按課程要求核實和修訂教材。文章綜合訪談及觀課所見,介紹把AI答案帶進課堂,讓學生分析準確性、立場與遺漏,或以模擬角色觀點展開小組討論。課後習作則要求交代AI用途和來源,評核着重知識理解及論證。學校亦須提供賬號、設備、使用指引、評核原則和同儕交流,支援教師持續調整教學。
研究讓132名澳洲大學生觀看不同AI感測及介入情境,比較目光或面部感測、系統提示和教師協助,並排列倫理考慮的重要性。學生重視適時支援,對AI監察則較負面,較偏好系統提示,理由涉及自主及在同學面前的尷尬。自主和私隱在倫理排序中居前。研究量度影片引發的感受及預期影響,沒有測試真實監察系統的準確度或長期學習成效。
研究在354名大學生的入門經濟學課程中,比較助教自行撰寫評語與使用FeedbackWriter建議的評語,共處理1,366篇稿件。助教可採納、修改或刪除AI建議;收到AI輔助評語的學生,修訂稿質素較佳,評語亦較具體可行,但後測成績未見顯著差異。研究的修訂稿評分主要依賴語言模型,並以部分真人評分核對,作品改善未必代表知識保留。